原创角色还没有样音,不必先找一位真人模仿。可以用AniShort的SeedAudio文字生成路线探索虚构声音:先规定稳定的声音特征,再用一致试读材料比较候选。目标是设计一个适合角色的新声音,不是从人物图还原他本来应该有的真实声线。
把声音特征和本场情绪分开
稳定特征可先写音区倾向、质感、咬字习惯与整体发声状态;当前场次的急切、犹豫或愤怒则另写。若第一轮就同时要求低沉、尖细、气息弱而爆发强,候选很难形成可比较的方向。
自拟一个角色需要“中等偏低音区,声音较干,字头清楚,不刻意压喉”。先用平静台词测试这些特征;喜欢的方向确定后,再测试疑问和情绪变化。不要用某职业、年龄或外貌直接推导唯一声音,也不以真实演员姓名替代可听特征。
可先查看产品详情,再由详情页前往官网了解声音生成。
用文字路线做同文试音
官方课124展示SeedAudio和纯文字等生成方式,字节Seed的模型说明也确认可用文字描述目标声音。准备本次声音要求与同一段原创试读材料,先确认当前生成方式,再生成候选。这里不依赖克隆样音,也不把角色图片当作真实声音证据。
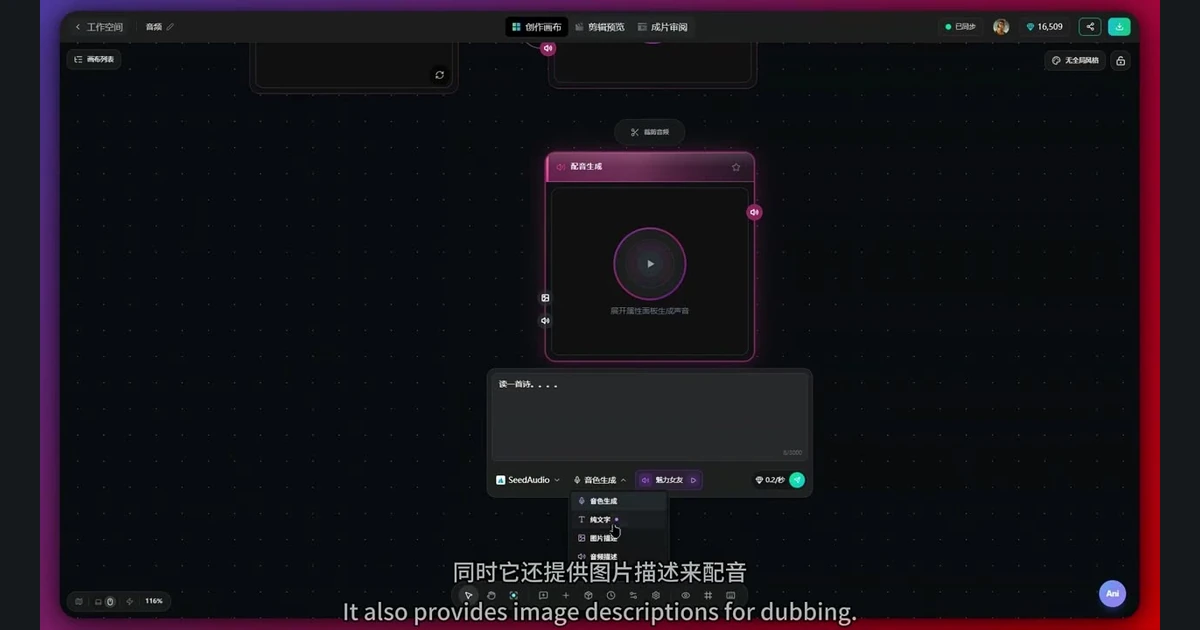
试读材料应包含几种自然句型,而不是只读一个响亮口号。可以有一句陈述、一句问话和一个需要清楚收尾的长短搭配,让你听到声音在不同发声动作下的样子。比较候选时保持材料一致,避免台词内容本身左右喜好。
候选先按听感编号,再揭开描述
先听哪份字头清楚、尾音是否过重、气息感是否妨碍理解,再回看它对应的描述。否则看见“沉稳可靠”很容易替实际发虚的声音补上想象。记录可听到的差异,而不是只说“更像主角”。
若某候选只在平静句里合适,再用同一声音方向测试本剧确实会出现的表达,不必立刻把它设为全剧定案。情绪变了之后声音是否仍可辨,需要实际试听;模型宣传的稳定性不等于这份具体候选已经通过。
定案要保留可继续使用的材料
保存采用音频、原描述、试读文字及选择原因。后续若当前模型支持并允许以这份生成音频继续作为参考,再据实际入口使用;不要把一段音频自动称作已经注册的永久音色。平台主体库、音色保存和当前模型引用是不同条件,应分别确认。
最终得到的是原创角色的声音方向及可试听样本。角色长相可以辅助创作讨论,却不能证明某种嗓音才是“真实还原”;这条边界保留下来,后续换台词时才不会围绕错误承诺返工。
备好角色声音要求后,可从详情页前往官网继续试音。
© 版权声明
文章版权归作者所有,未经允许请勿转载。


相关文章




暂无评论...