AI对口型视频怎么制作?许多人第一次试做时,会把一张人物图和一段音频一起上传,生成后才发现嘴形追不上台词,转头时嘴部漂移,句末停顿也被吞掉。对口型效果是否可信,靠的不是把台词念得更快,而是先让人物图、说话内容和节奏信息彼此对得上。
如果素材来自真实人物,先确认本人同意、声音和肖像可用;如果是角色图,也要保留角色版本和来源。下面的流程适合做短剧情对白、知识讲解开场和角色口播测试,重点是先用短片段把嘴形与停顿校准,再扩展到完整内容。
先准备三样相互对应的素材
对口型的输入越混乱,生成后越难判断问题出在哪。开始前不要急着拿一整段三分钟旁白测试,先选一段 8 到 15 秒、说话速度自然、没有背景杂音的片段。人物图也要能看清正脸或半侧脸,嘴部不要被手、麦克风、头发或大面积阴影挡住。
- 人物图:用表情稳定、清晰度足够的角色图;一个镜头尽量只出现一个明确说话主体。
- 台词或音频:文字稿要与实际音频逐句一致,人名、英文缩写、数字和停顿先统一写法。
- 镜头意图:写明人物是正面讲解、轻微点头,还是需要转头、抬手等动作。嘴部动作复杂时,先降低其他动作幅度。
角色图和音频不一定都需要一次上传到同一个位置,具体入口会随着账号和版本调整。但无论页面上是“自动口型”“一键对口型”还是相关视频生成选项,核心都是给系统一张可辨认的说话主体和一段可校对的语音材料。
已经选好人物图和第一句台词后,先用短片段测试嘴形是否跟得上声音。
AI对口型视频怎么制作?先把人物图、台词和停顿对齐
- 用完整句子建立第一版口播。不要把一句话拆成大量单字片段。保留自然的句号、逗号和停顿,语气词只在确实需要人物表情时留下。
- 先做单人、近景、短时长测试。一开始就做多人对话、远景走动或快速切镜,很难分辨问题来自口型、声音还是镜头。先验证一个人开口说一句完整话。
- 让画面动作服从说话节奏。说到重点时可以有轻微抬眼或点头,但不要同时要求大幅转头、遮挡嘴部或夸张表情。音频停顿时,画面也应给人物一个自然的静止或呼吸空间。
- 对照声音逐句复看。先关掉字幕看嘴形,再打开音频听重音和停顿,最后加上字幕检查三者是否一致。发现一句不对时,只重做该句附近的镜头更容易保留前后版本。
常见的错误不是嘴形完全不动,而是个别爆破音、长元音和句尾收音错位。试听时特别看“b、p、m”这类闭唇音,以及台词里连续数字或英文单词。若原音频语速太快,先把句子改短或留出停顿,再重新生成,比强行加速画面更自然。
人物图该怎么选,才不会开口后变形
适合对口型测试的角色图,不必追求复杂背景,重点是脸部轮廓、嘴唇边缘和下巴线条能被清楚识别。正面或轻微侧脸通常更容易检验;极端仰拍、俯拍、强逆光、嘴部被道具遮挡的图片适合做氛围镜头,却不适合作为第一轮说话镜头。
| 素材情况 | 容易出现的问题 | 先怎么处理 |
|---|---|---|
| 人物太小 | 嘴部细节不足,难判断同步 | 换成半身或近景角色图 |
| 嘴部被遮挡 | 口型断裂、边缘闪动 | 移开手部、口罩、话筒等遮挡物 |
| 台词太长 | 后半句节奏漂移 | 按自然段落拆成两句测试 |
| 动作过多 | 转头时口型与脸部不稳 | 先锁定说话镜头,再补动作镜头 |
角色需要在多个镜头里连续说话时,建议先固定一张主参考图,再为表情、服装或场景变化建立单独版本。不要同一角色每段都临时换图,否则即使每段口型各自自然,剪到一起也会显得不像同一个人。
在 Seko 中先做一段可复看的说话镜头
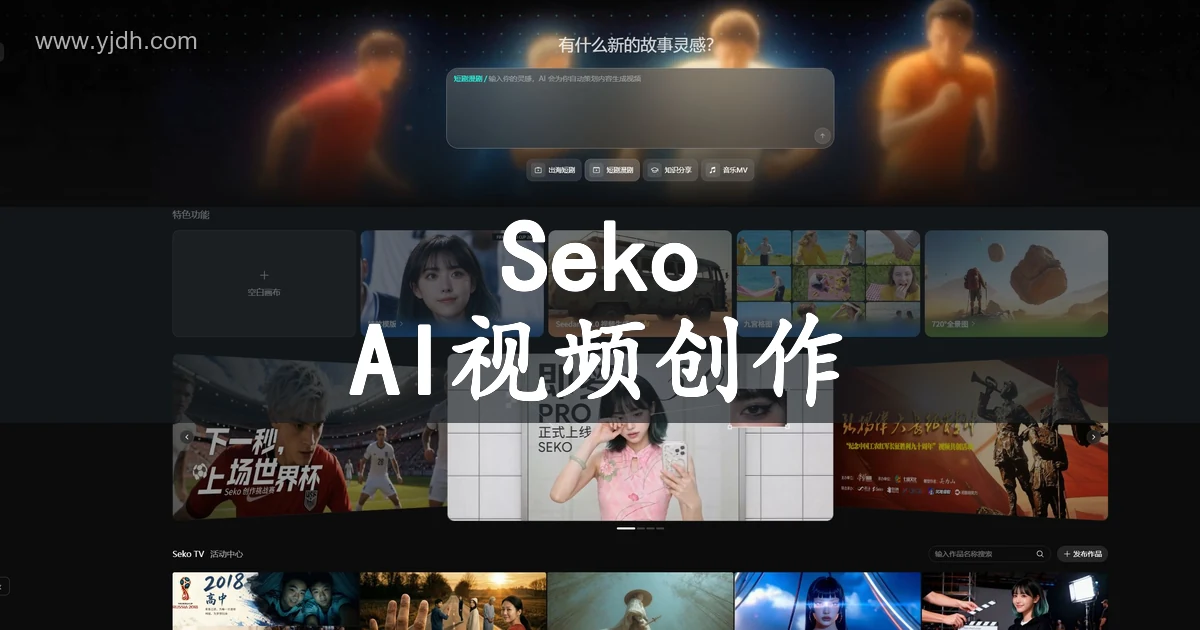
Seko 公开的 AI 视频创作入口覆盖故事策划、视频生成、主体素材、配音和画布等环节,并提供自动口型相关的生成能力。做对口型任务时,可以先把角色、台词、情绪和镜头动作放在同一个小任务中:例如“角色正面对镜头说两句产品介绍,语速自然,第二句前停半秒,镜头保持半身近景”。先得到一段可复看的候选镜头,再决定是否接入完整故事或分镜。
角色:半身近景,正对镜头,神情平静
台词:今天先看一个真实问题。停顿半秒,再说:解决它只要两步。
声音:中文普通话,语速自然,句末完整收音
画面:不遮挡嘴部,不新增文字,不突然转头
检查:闭唇音、停顿、字幕和嘴形逐句对应
工具能帮助生成候选画面,不代表台词事实、人物授权和素材版权已经自动成立。涉及品牌、新闻、医疗、金融建议或真实人物时,发布前仍需逐项回到可靠来源和使用许可核对。
想先确认角色开口时是否自然,就上传一张清晰角色图,生成一段短台词预览后再继续扩展镜头。
成片前用这份清单检查口型
- 每一句台词是否与实际音频完全相同,是否有错字、漏字或被改读的数字。
- 嘴唇闭合、张开和句尾停顿是否与声音一致,特别复看爆破音和英文缩写。
- 镜头切换时,人物的衣服、发型、光线和说话状态是否连续。
- 字幕是否遮住嘴部或与音频提前、延后出现。
- 人物肖像、声音、音乐、字体和背景素材是否有明确的使用许可。
先把一段短口播做自然,再把规则复制到更长的对话中,通常比一开始追求一镜到底更省时间。任何自动生成的镜头都应人工复看,口型对齐只是基础,观众最终感受到的仍是人物、故事和声音是否在同一个节奏里。
常见问题
AI对口型视频一定要真人照片吗? 不一定,插画角色或虚拟角色也可以尝试。但无论使用哪种图,都应确保脸部和嘴部足够清楚,并确认素材的使用权。
一段台词应该多长? 第一轮建议从一两句自然口播开始。先验证语速、嘴形和停顿,再分段扩展到完整内容。
音频有杂音还能做吗? 能否使用取决于实际工具和素材质量,但杂音会增加复看成本。先用清楚的人声测试,再决定是否处理原始录音。
对口型做好后能直接发布吗? 不能只看嘴形。还要检查台词事实、肖像与声音授权、字幕、音乐和目标平台规则。