Cherry Studio – 开源全能AI客户端助手
Cherry Studio是一款开源的全能AI桌面客户端,支持聚合管理多平台AI模型、构建本地知识库,并集成AI绘画与翻译等功能。
Meta AI研究资源是面向研究者、开发者和学习者的官方资源入口,按研究框架、工具、模型与库、数据集和基准等方向组织资料。它适合已经有一个具体问题、希望找到相关官方项目和技术说明的人,例如寻找可阅读的模型文档,或了解某种研究方法如何实现。
这个资源页的主要作用是帮助查找和理解研究成果。它与面向个人问答的Meta AI助手用途不同,也不局限于某一个模型版本。用户进入具体项目后,仍需要阅读该项目的文档、许可与使用条件。
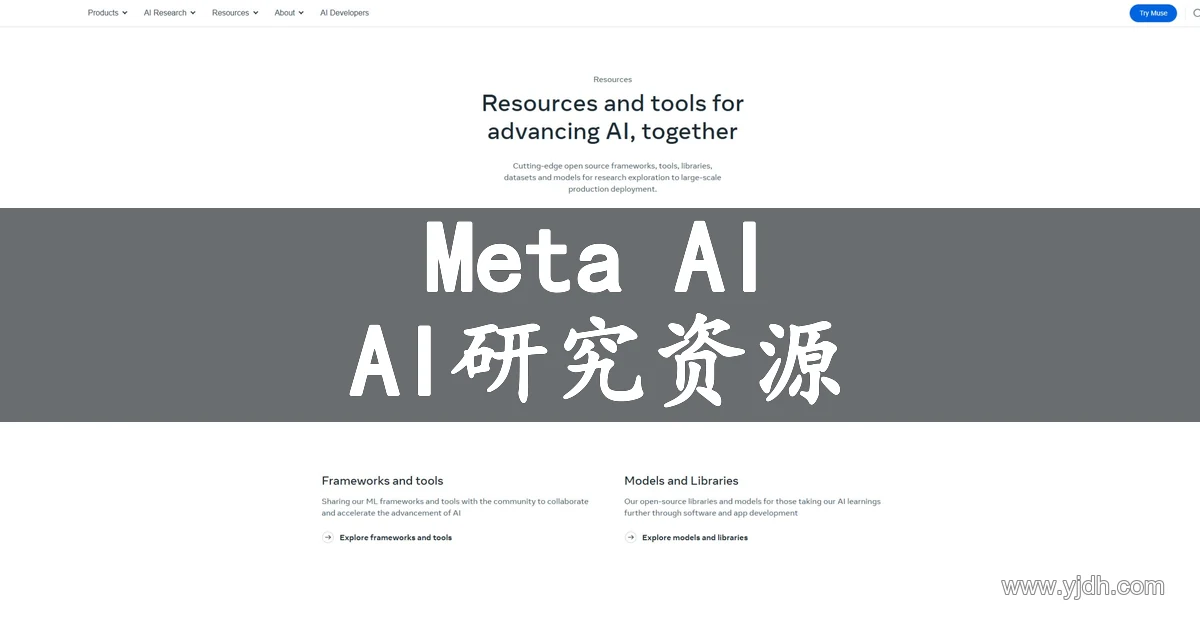
这些类别构成的是资源导航,并不表示每项材料都能直接在线运行。项目可能要求填写访问申请、遵守许可或在指定环境中使用,具体条件应以对应页面为准。
| 研究目标 | 优先查看 | 需要确认 |
|---|---|---|
| 理解一种方法 | 论文与项目说明 | 问题定义和适用前提 |
| 准备开发原型 | 框架、工具与模型库 | 安装环境和依赖 |
| 比较方法表现 | 数据集与基准 | 数据划分和指标定义 |
| 了解能力边界 | 系统卡与演示 | 限制、示例与真实任务差别 |
同一研究方向可能同时涉及模型、数据和评估方案。把这些材料对应起来,比只下载一个模型文件更有助于正确理解方法。
如果只是学习概念,可先读论文与演示,不必立刻配置大型模型。若是准备开发原型,则要把环境条件和许可证作为筛选标准,避免选到无法在现有设备上使用的资源。
模型名称往往包含版本、规模或任务方向,不能只看相近的名字就把不同项目当成同一种资源。阅读资料时,应确认输入形式、输出形式、预期用途以及官方列出的限制。模型可以下载,并不意味着它适用于任意语言、领域或业务场景。
软件库还应关注安装方法、依赖环境、维护状态和示例所使用的版本。把项目说明中的演示流程改为自己的任务时,可以先保留原始示例,再逐项调整材料和参数,这样更容易定位差异产生在哪个环节。
使用数据集前,先了解数据如何获得、如何标注、允许哪些用途,以及是否需要额外申请。一个数据集适合研究某类问题,不代表它覆盖了所有真实人群和使用环境。内容中出现某个字段,也不代表能够随意将其与其他个人信息组合使用。
比较基准时,应同时阅读训练、验证与测试划分,以及指标所衡量的能力。不同数据划分、预处理或硬件条件下得到的数值,不宜直接并列成性能结论。清楚说明实验条件,才能让后续比较有可解释性。
演示适合快速理解一个项目的交互方式和典型输出,但展示案例通常经过筛选,不能代表所有输入上的稳定效果。可以先观察示例解决了什么问题,再设计与自己任务接近的小样本,检查是否存在失败类型或明显偏差。
系统卡和限制说明则帮助理解预期用途、已知风险及评估范围。对于需要准确事实或涉及个人权益的场景,模型输出仍应经过相应领域的人工核对,不能把一个研究演示直接当作完整业务系统投入使用。
机器学习学习者可用它建立“论文、实现、数据、评估”的对应关系;研究者可用来寻找项目资料和比较方法;开发团队则可先评估许可和环境,再选择适合原型验证的组件。资源页提供了入口,具体学习顺序仍应围绕一个明确任务安排。
团队协作时,可将选中的项目名称、版本、许可摘要与环境要求放在同一项目说明中。这样后续成员能够理解为何采用该资源,而不是仅收到一个下载文件或无法解释的实验结果。
先确认下载地址确实来自项目公开说明,再检查所需空间、计算资源和依赖。大型数据和模型可能需要较长准备时间,是否适合当前任务应在下载前判断。遇到访问申请或地区、账户条件时,按项目页面的实际要求处理。
对结果的描述应限定在自己的实验材料与条件内。开放资料也可能附有署名、研究用途或其他限制,面向客户的交付还需检查相关许可。资源入口便于发现项目,是否能够用于特定产品仍取决于该项目自身的规则。
Q:它是Meta AI聊天助手吗?
A:这里介绍的是Meta AI官方研究资源页,主要用于查找研究框架、模型、数据集和技术说明,与个人聊天助手的使用目的不同。
Q:页面中的资源都开源吗?
A:各项目的开放形式和许可不同。需要进入具体项目核对,不能把统一资源入口理解为所有材料都采用同一开源许可证。
Q:找到模型后就能直接运行吗?
A:需要先确认访问权限、硬件、软件环境和依赖。有些项目有在线演示,有些则需要下载后在自己的环境中准备。
Q:如何选择适合的基准?
A:先匹配研究任务,再读数据划分、指标和评估条件。不同设置下的分数不能直接替代实际任务中的结果。
Q:演示效果可以作为性能保证吗?
A:演示用于理解能力和交互,不是对任意输入的保证。实际使用应准备与自己任务相关的材料进行验证。
Q:可以用于商业项目吗?
A:应逐项查看所使用模型、库和数据的许可及访问条件。资源被公开列出,不代表已经获得任意商业使用权限。
本站AI工具导航提供的Meta AI – AI研究资源都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由AI工具导航实际控制,在2026年10月27日 上午11:10收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,AI工具导航不承担任何责任。