AI应用怎么部署到云服务器?上线前先核对这4个运行要素
把一个能在电脑上跑通的 AI 小工具放到云服务器,并不等于把代码上传完就结束。真正容易出问题的是:模型调用明明能返回结果,网页却打不开;测试数据和正式数据混在一起;生成任务一多,谁在处理、失败后怎么恢复都说不清。先把运行任务、服务边界、环境配置和上线后的观察方式分开,第一次部署才有可核对的起点。
先把一个可运行的版本放上去。
把当前要解决的任务、输入内容和结果交付方式写成一张清单后,再进入部署准备。
第一步:先说清楚这台服务要负责什么
“部署 AI 应用”里至少有两类东西:模型能力和你的应用服务。模型能力负责理解、生成或识别;应用服务负责接收用户操作、组织输入、保存必要记录并把结果显示出来。两者混成一句“把 AI 部署上去”,后面出了问题很难判断该看模型调用,还是看网页、后端和数据。
开始前可以只选一个最小任务,例如“把一段客户咨询整理成待办”,而不是同时塞进问答、文件处理、图片生成和自动通知。写清楚输入从哪里来、结果交给谁、什么情况算完成,部署后的第一条链路才有明确验收标准。
- 输入:用户提交的是文字、文件、图片还是音频,是否需要先做格式检查。
- 处理:哪一段由模型完成,哪一段由应用规则完成。
- 输出:结果是在网页上显示、交给人工确认,还是传入下一项业务流程。
第二步:把“能跑”拆成服务、配置和数据三部分
很多测试版之所以一换环境就失效,不是模型突然变了,而是运行它所需的内容散落在个人电脑里。代码或应用服务、环境变量和配置、要保存的数据,应该在上线前各有归处。不要把账号信息、密钥或测试文件硬写进页面和代码,也不要让每个成员各自保存一套无法说明版本的配置。
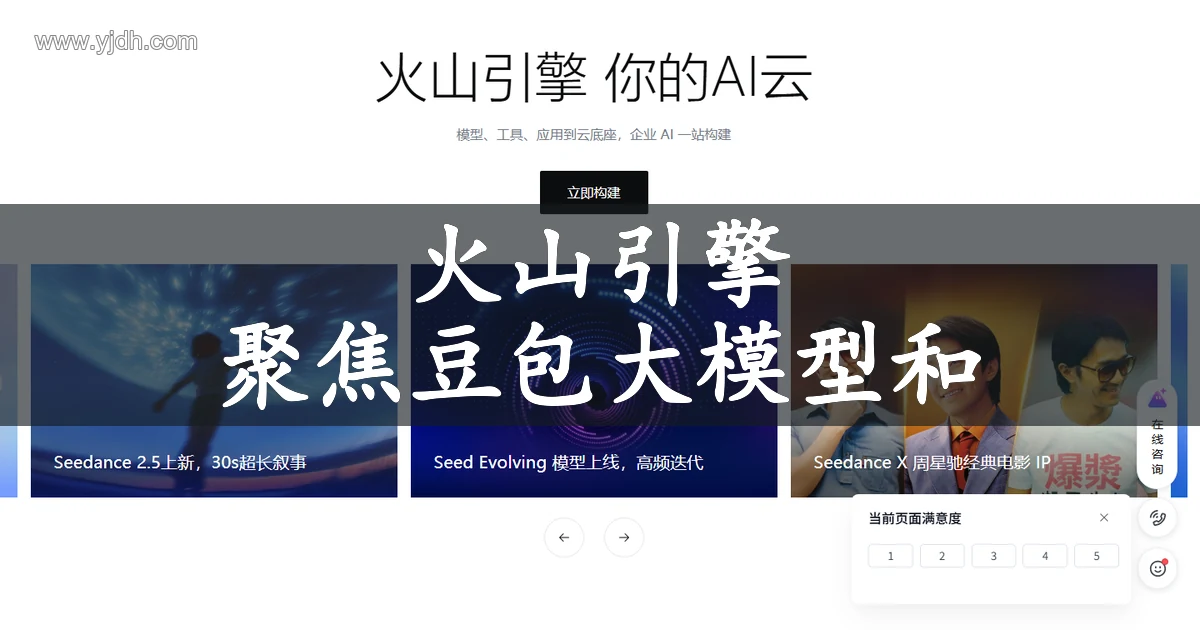
火山引擎的公开页面把模型、应用与云底座放在同一条建设链路里,并展示云服务器、对象存储和云数据库等方向。对正在做原型的团队来说,重点不是一次把所有产品都用上,而是先决定应用服务在哪里运行、文件放在哪里、哪些业务记录需要被保存,再按真实任务逐项补齐。
| 部分 | 上线前要确认的问题 |
|---|---|
| 应用服务 | 启动方式、依赖版本、访问地址和异常时的提示是否写清。 |
| 运行配置 | 模型标识、环境变量和权限是否与代码分开管理。 |
| 业务数据 | 用户提交内容、生成结果和必要的任务状态分别保存在哪里。 |
第三步:测试环境不要直接拿来接正式用户
先用一小组不敏感的样例跑完整流程,分别检查网页提交、模型处理、结果展示和失败提示。测试通过后,再建立正式运行时所用的配置和数据位置。这样做的价值不在于增加流程,而是在修改提示词、模型或业务规则时,能知道改动会影响哪里。
尤其是含有文件上传、客户信息或内部资料的应用,测试材料和正式材料应当分开。让团队成员知道哪些内容可以用于试验、谁负责确认结果、出现异常时先暂停哪一段,比上线后才临时寻找责任人更稳妥。
- 准备 3 至 5 条代表性样例,覆盖正常输入、缺字段和明显无效输入。
- 记录每条样例从提交到结果出现的路径,先看最容易中断的环节。
- 把确认通过的配置单独留存,避免测试时的临时改动进入正式环境。
- 正式开放前,再让非开发同事按真实操作试一次,检查说明和结果是否能看懂。
第四步:上线后先盯住任务是否完成,不只盯页面能否打开
AI 应用上线后,页面能访问只是起点。更有意义的是确认:用户提交后有没有得到可用结果;失败时有没有清楚提示;重复提交会不会制造两条任务;人工复核后能不能找到原始输入。把这几项写成一张上线检查表,后续更换模型或扩展功能时也能继续使用。
对于需要持续运行的任务,最好留下最少量、可解释的状态记录,例如任务开始、处理中、完成和需要人工处理。不要为了“看起来很智能”而自动做出不可逆的业务决定。先让人能看懂结果和异常,再考虑扩大自动化范围。
准备上线前,先核对运行边界。
查看火山引擎的模型、应用和云服务入口,为当前这一个 AI 任务选择合适的继续路径。
常见疑问
AI 应用部署到云服务器,是不是必须先把模型装进服务器?不一定。先分清模型能力由哪里提供、你的应用服务由哪里运行,再决定需要准备什么。不要在任务边界尚未明确时,把所有组件都堆到同一台环境里。
原型跑通后,为什么还要留测试环境?因为提示词、模型选择、业务规则和页面都会变化。保留可复现的测试路径,能在修改前后比较结果,减少影响正式使用的概率。
上线第一版该做到多复杂?先让一个明确任务从输入到结果完整闭环即可。能观察、能复核、出错能处理,比一次性增加很多功能更重要。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...