想生成一段歌曲,结果连“钢琴轻一点、最后不要太激昂”都被唱出来,先检查它们是不是进入了歌词输入。AniShort官方音频课程展示的音乐节点有“写词模式:直接歌词”。在这种状态下,输入应当先被当作需要演唱的文本来检查,不能把所有制作要求都粘进同一段。
先圈出真正要被唱出的句子
拿一个原创小例子:“窗边的灯还没熄,你把回信放在这里。钢琴轻一点,结尾不要太激昂。”前两句是歌曲内容,最后一句是制作方向。若它们混在直接歌词里,作者自己就没有给出清楚的内容边界。先把制作方向取出,保留两句歌词,再决定如何表达音乐风格。
同样,“这一段表现和解”“女主此时犹豫”“这里等待画面转场”通常是创作说明,不一定是歌词。判断办法很直接:如果歌手真的把这句话唱出来,是否符合原意?不符合,就不要仅靠换行或加括号,指望模型一定把它理解成不发声的指令。
先看当前写词模式,再整理输入
官方“音频节点用法大全”212秒处的音乐生成面板可见“写词模式:直接歌词”。开始前先查看自己当前的模式和字段提示。需要演唱已有原词时,整理后的歌词单独放入对应输入;想从一个主题生成新歌词时,先确认当前模式是否支持这种描述输入,没有确认就先把歌词写好,不假定同一个框能自动识别两种任务。
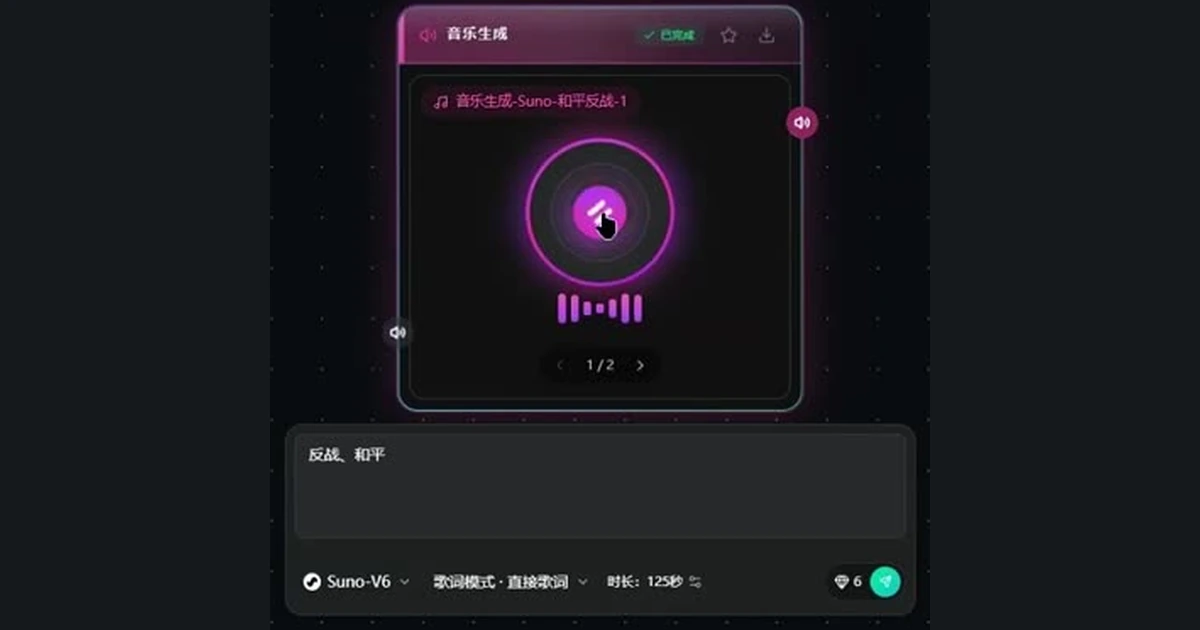
曲风、乐器、情绪与时长另行记录,按当前节点实际提供的选项填写。没有独立字段时,不把一大串说明重新塞回歌词尾部;可以先用当前可控的条件完成一份短歌词试唱,再决定是否需要其他制作方式。
需要了解音乐生成节点,可查看AniShort详情,再经详情页的官网入口查看当前教程。
从被误唱的位置回查,不整首重写
先记录误唱的是哪一句,然后回到本轮实际提交文本核对。制作说明残留在输入中,就先删除这一处;歌词已干净而结果仍新增话语,再记为输出新增,不能归咎于根本不存在的输入文字。保留原音频,避免下一轮生成后已经记不清是哪版唱错。
修正后试听完整段落,不只听被删那一句。确认原词没有被连带漏掉,前后意思仍成立,结尾也没有把其他说明补唱进去。若同一轮顺便改了歌词与曲风,分开写出改动,不能把听感变化全部归给模式设置。
结构标记也需要听,不能只看符号正确
主歌、副歌等标记在不同模型或输入方式中的处理可能不同。按当前支持方式使用,生成后实际听有没有被读出、是否形成需要的段落。不要把某个模型常见的方括号语法当成所有音乐节点的共同规则,更不要给歌词套满未经验证的特殊标签。
最后保存三份简短材料:真正要唱的原词、音乐方向、采用音频。它们分别回答“唱什么、怎样唱、最后用了哪份”。这次排错完成的标准是制作说明没有误入演唱、原词仍完整可用;不是顺手给歌曲重新设计一套主副歌结构。
原词与制作方向分清后,可到AniShort详情了解产品,再从官网入口继续试唱。