PDF剧本看着顺畅,复制出来却把对白、动作和页眉混在一起,先修阅读顺序,再交给AniShort分段。排版上的左右位置不一定能原样变成文本顺序;让模型给一串错序文字润色,可能得到流畅却改了人物行为的新故事。
先选一处能暴露问题的页面
虚构剧本的一页左侧写“沈青把信藏进书里”,右侧是下一场对白“我没见过这封信”。复制后若变成先说没见过、再藏信,行为的先后已经改变。先对照这一页和前后页,确认是两栏串读、跨页接句,还是页码被插入正文,不用一开始就重整整部剧。
另外检查三类高风险位置:人物名与紧随的对白有没有分开;括号中的动作是否落到错误说话人下面;跨页延续的句子是否被页脚切断。原页面是核对依据,提取出的文本只是待校正输入。没有看清的字先标待确认,别凭剧情猜补。
先备好可按顺序阅读的剧本文本,再查看下一页AniShort详情及官网入口,继续智能分段。
版面修复与剧情改写分开做
能回到原编辑文件时,优先按正文顺序导出;只能处理PDF,就按实际版面逐栏、逐页取文。扫描图需要先用适合的文字识别工具取得文本,再人工对页;这一步在外部完成,不把AniShort的剧本处理当作PDF阅读顺序修复器。
清理时保留场次、人物标签、对白和动作之间的关系。删掉重复页眉可以,顺手删掉每页开头的场次号就可能丢掉定位。将“第8页”“作者署名”等排版信息移出输入正文,同时在单独记录里保留页码对应,方便以后找到发生错序的原位置。
再交给剧本分段,先检查它读到了什么
AniShort的剧本路线包含上传剧本、脚本拆分、剧本分段与主体提取。把校正后的文本按当前入口允许的方式提交,保留原PDF。先选择刚才那一处有藏信动作的段落,核对分段结果中的人物、场景和内容,确认“藏信”仍在“否认见过”之前。
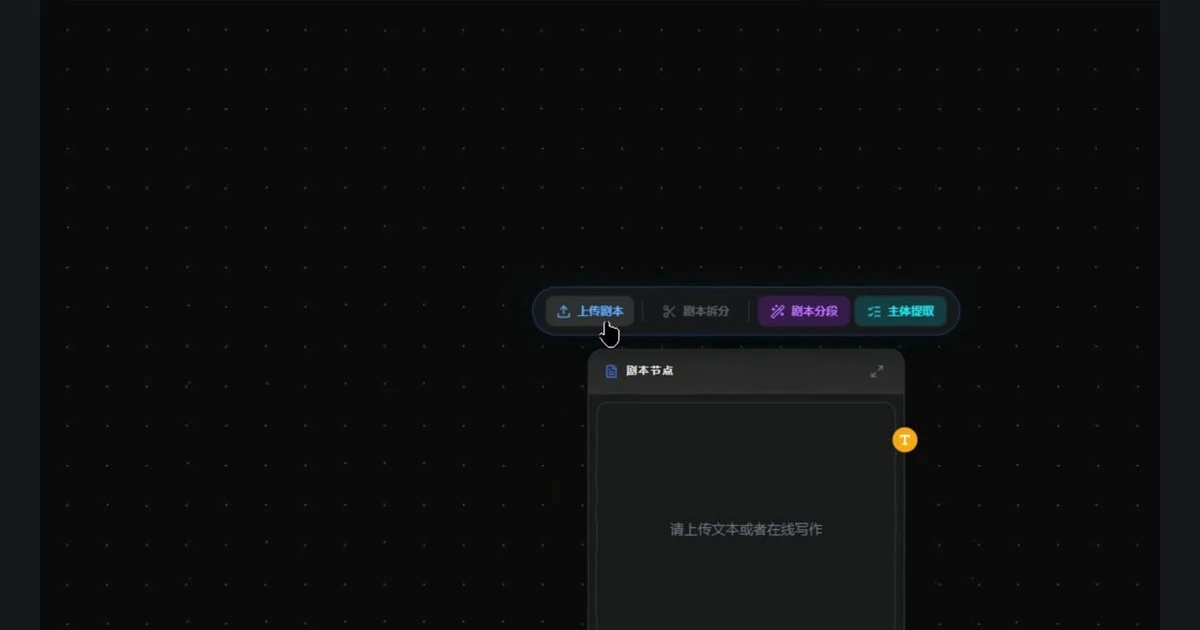
这轮先检查读入是否忠实,再决定要不要润色。若同时要求改节奏、增强冲突、修对白,就很难分清少了一句是提取遗漏还是改写取舍。输入顺序仍不对时,回到文本准备;输入正确而分段漏动作,才处理段落边界。
用相邻两页做一次往返核对
从分段稿选一个跨页位置,回到原PDF找到对应动作与对白,再从原页顺着读回分段稿。检查有没有重复读一次、跨栏跳过一句,或把下一场的人物留在上一场。这种往返比只看生成稿是否通顺,更容易发现文本在入口处已经错位。
完成时留一份能独立阅读的剧本输入,以及需要回原页确认的位置。后续人物、场景与道具提示词应基于这份输入继续,不能让一次OCR猜测成为角色身份或事件顺序的唯一依据。原文字句有争议时,先解决争议再扩到全剧。
正文顺序与原页对应无误后,可经下一页AniShort详情进入官网,继续分段和主体准备。