解释片里同一个词突然换了含义,应在切换发生时重新定位,而不只在开头给一次定义。先为每种含义配具体对象、限定称呼与使用语境,再安排切镜。观众知道眼前这个词指什么,才不会把上一段的解释套到下一段。
用“模型”的三种语境练习
下面是本文的讲解用词约定:生成段的“模型”指所选的AI生成模型,三维段的“模型”指画面里的三维对象,原理段的“模型”指简化关系的解释方式。三者不是同一对象,本篇也不是评判谁合格,而是解决同一词跟随语境换指向。
原旁白若说“换个模型,再把模型简化一下”,听者可能不知简化哪个。可改为:“先比较生成所用的AI模型;接下来只看三维对象的形状;最后用简化关系图解释过程。”定义和实际入口按对应资料核对,不从名称推断可调整哪些参数。
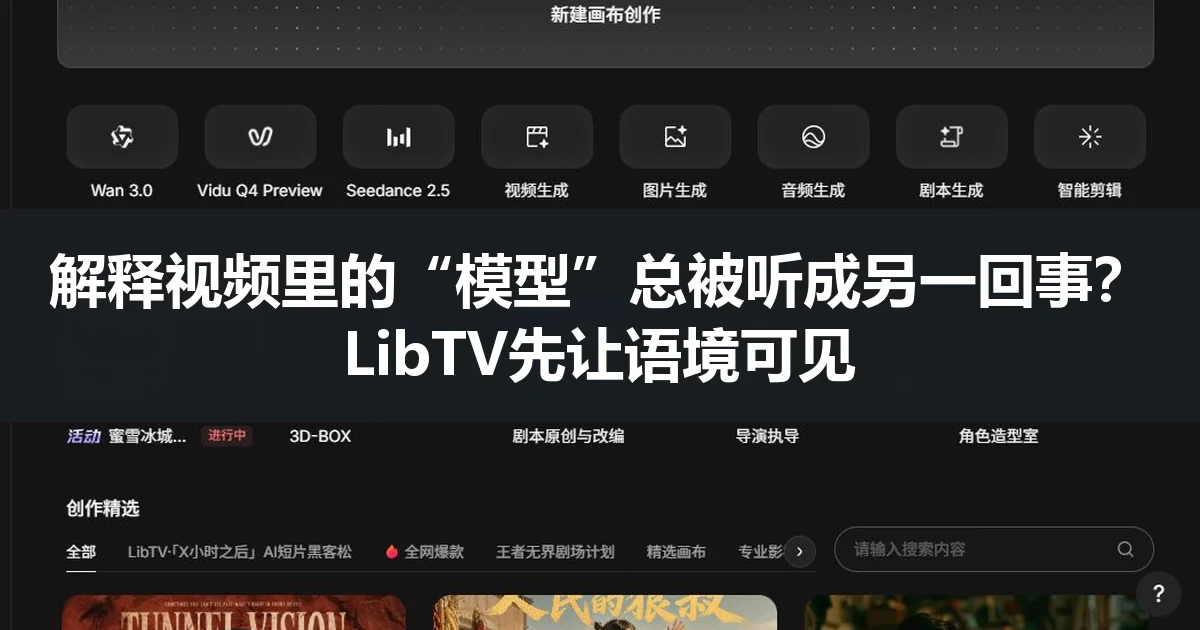
备好容易串义的原句和各自对象,可到LibTV产品详情查看剧本、画布与官网入口,规划语境定位镜头。
语境切换卡需要四项
- 当前指向:写完整限定称呼,不只写“模型”。
- 视觉锚点:生成段用核实过的名称说明;三维段用可辨形状;解释段用明确标注的关系示意。
- 切换句:在新对象出现前后说明“现在转到场景中的三维对象”,不要让一个转场效果代替语义定位。
- 退出规则:后文再次返回时保留限定称呼,不让代词连续跨越不同对象。
示例第一卡写“生成所用AI模型,讨论输出选择,不讨论物件形状”;第二卡写“三维对象,讨论轮廓和部件,不代表更换所用AI生成模型”;第三卡写“简化解释图,只帮助理解关系,不是内部运行实拍”。同一词的三个对象由此各有画面归属。
画面先帮助指认,再帮助解释
先在脚本标出每次切换的句子,再用画布安排对应对象。样式可辅助识别,但不只靠颜色编码;限定称呼和具体对象也要清楚。关键标签使用核对过的文字素材,不把生成图里偶然出现的术语当准确字幕。
回到前一语境时,一句“回到生成所用的AI模型”即可,不必重讲全部定义。一镜里出现多种含义,就写明确对象,别连续说“它”“这个”。小节可能被单独观看时,入口也留最低限定,避免依赖观众记住很早的定义。
LibTV提供剧本、画布、视频创作及3D-BOX入口,可用于组织不同场景对照的解释镜头。真实配置由外部截图或录屏取得,生成情景只承担解释,不把示意当功能演示。
用指向问题检验,而非再做合格判断
让未参与写作的人顺着成片看,每次切换后说出该词指哪个对象、依据是什么。回答错时检查限定、锚点与过渡句,不让他判断资料包是否合格;再单独播放必要小节,看它开头能否自行定位。
最后交出语境切换卡、改写旁白与镜头对应。只改一个错字无需复杂视频;当同词跨语境反复串义,需要重新组织讲述与画面时,才进入本篇的创作任务。
带着语境切换卡与改写旁白继续。下一页是LibTV产品详情和官网入口,可准备指向清楚的解释画面。
© 版权声明
文章版权归作者所有,未经允许请勿转载。


相关文章



暂无评论...